Микросервисы упали, а аналитика молчит: настройка клиентского мониторинга критических эндпоинтов
Серверные дашборды показывают нормальные значения, но пользователи уходят без заказов из-за клиентских таймаутов и CORS-ошибок. Разбираемся, как настроить сквозной мониторинг API в браузере и связать сбои с потерей конверсии.
Почему бэкенд отчитывается о норме, когда сайт теряет клиентов
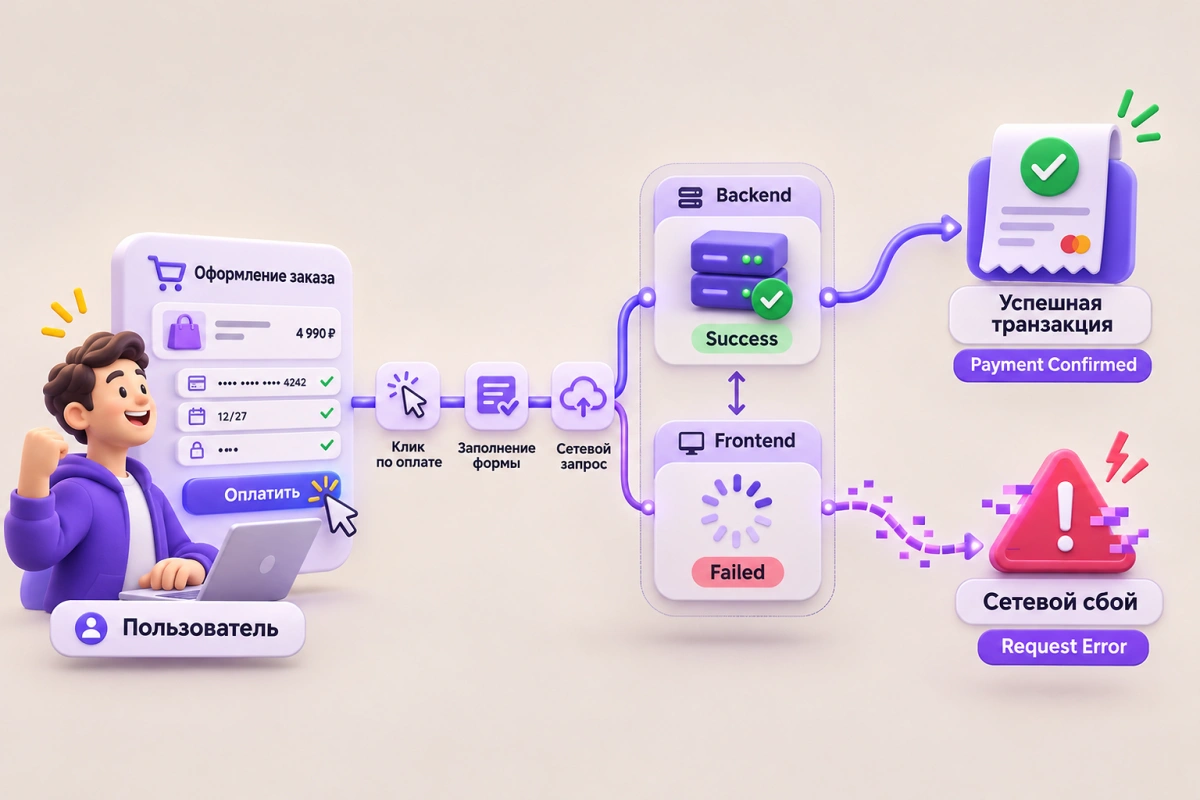
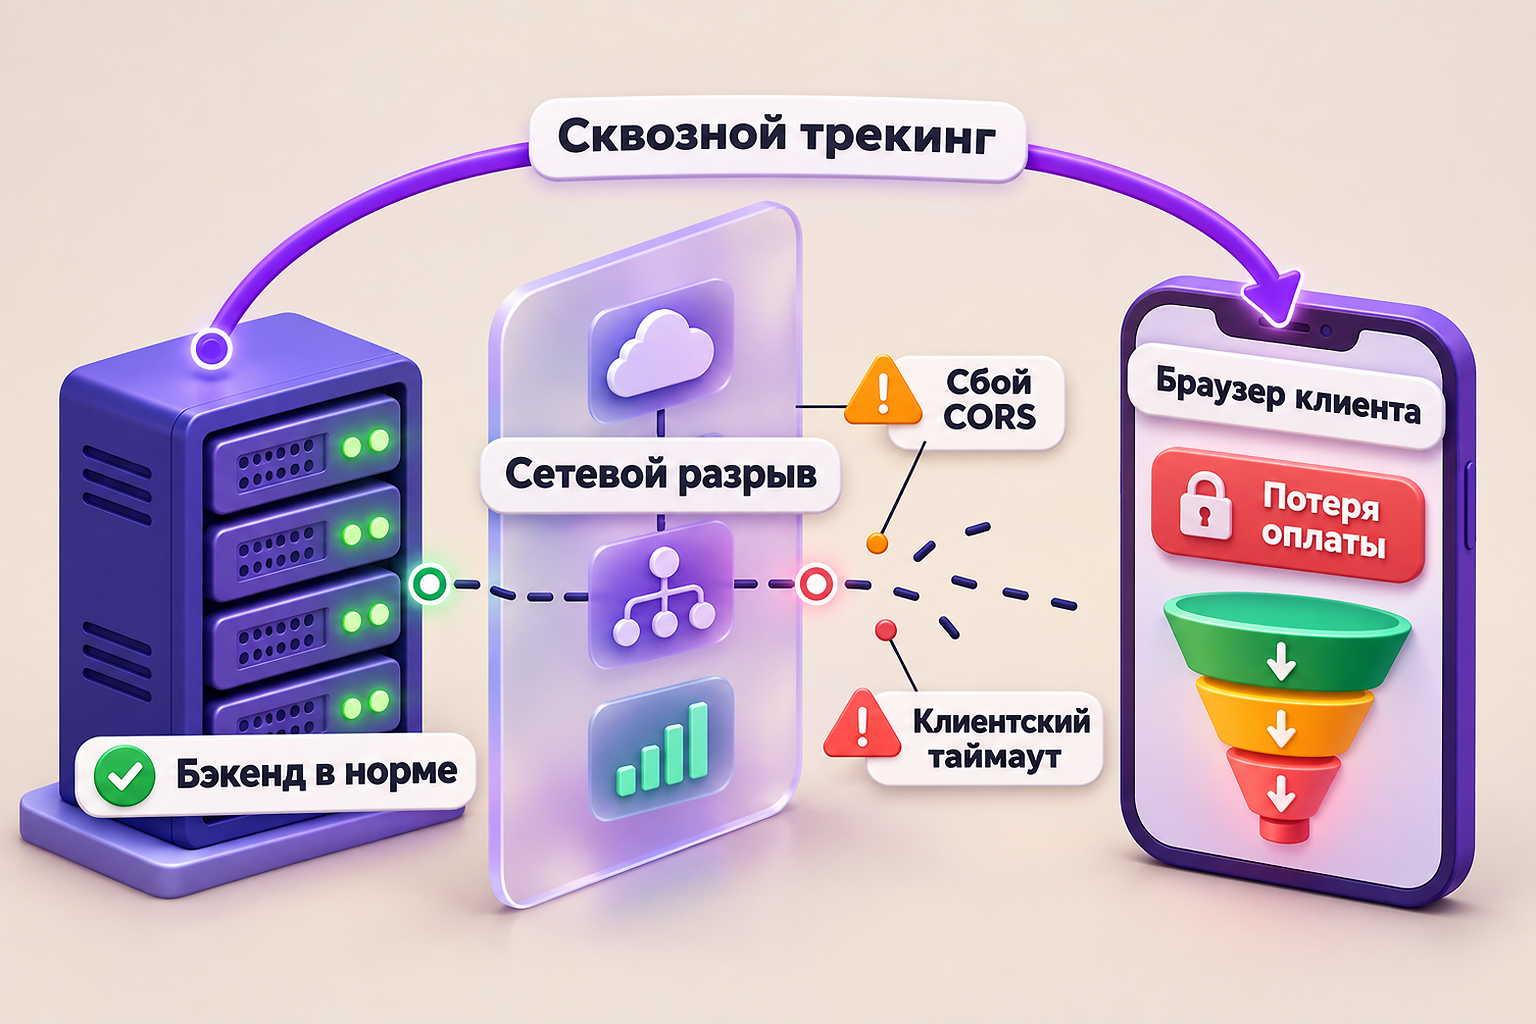
Серверные системы мониторинга оценивают инфраструктуру изнутри: они считают среднее время ответа микросервисов, нагрузку на базы данных и коды ответов внутри кластера. При этом клиентский контекст остаётся слепой зоной. Если промежуточный балансировщик сбросил соединение по таймауту, CDN вернул заголовок с ошибкой конфигурации CORS или мобильная сеть пользователя оборвала AJAX-запрос к платежному шлюзу, микросервис заказа может вообще не зафиксировать входящий трафик.
Для бизнеса эта ситуация выглядит парадоксально: по метрикам инженеров бэкенда все сервисы работают в штатном режиме, а в маркетинговых отчетах падает конверсия шага оплаты. Чтобы оперативно реагировать на реальные инциденты, данные о доступности API необходимо собирать непосредственно из браузера посетителя, связывая сетевые сбои с шагами воронки.
Разница между серверными и клиентскими сбоями API
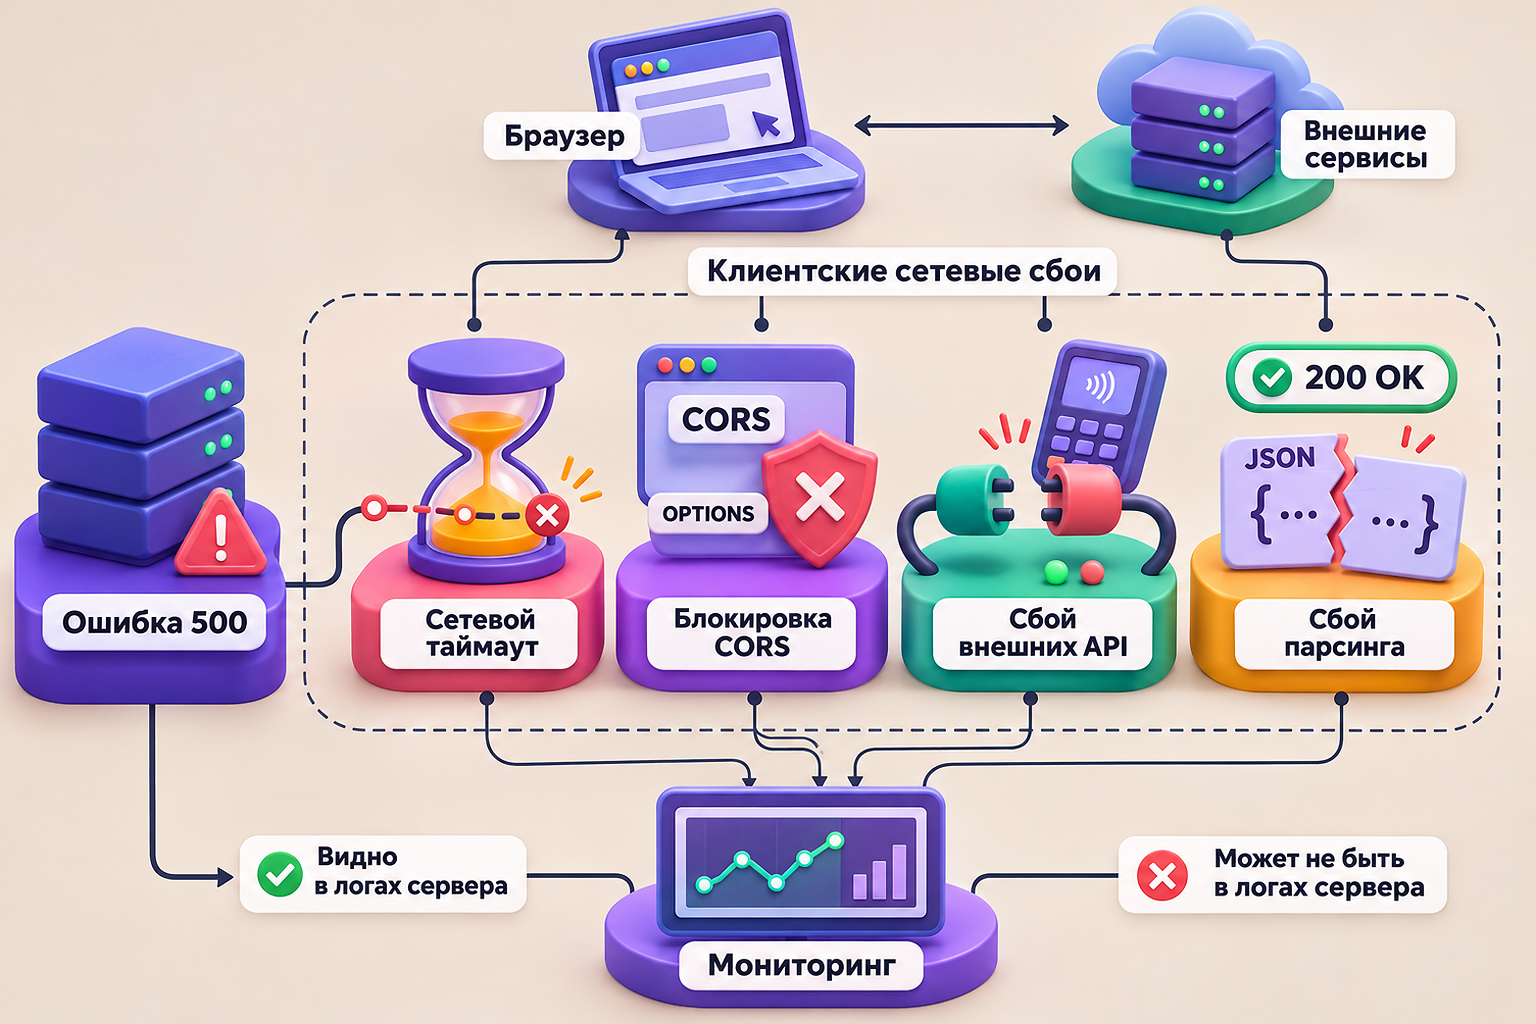
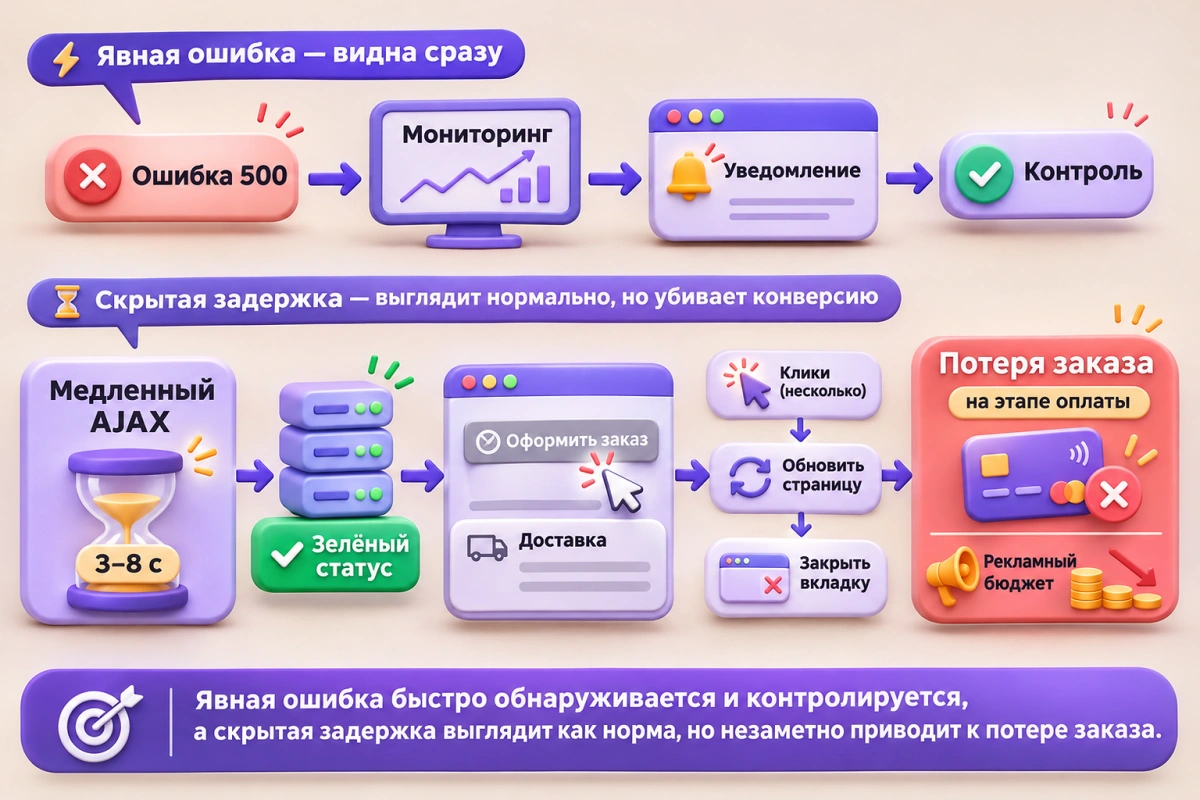
Когда микросервис падает с внутренней ошибкой 500, бэкенд обычно регистрирует событие в централизованном хранилище логов. Намного сложнее обнаружить проблемы сетевого транспорта, некорректных клиентских заголовков или специфических сбоев сторонних интеграций, которые происходят на стыке браузера и внешнего контура.
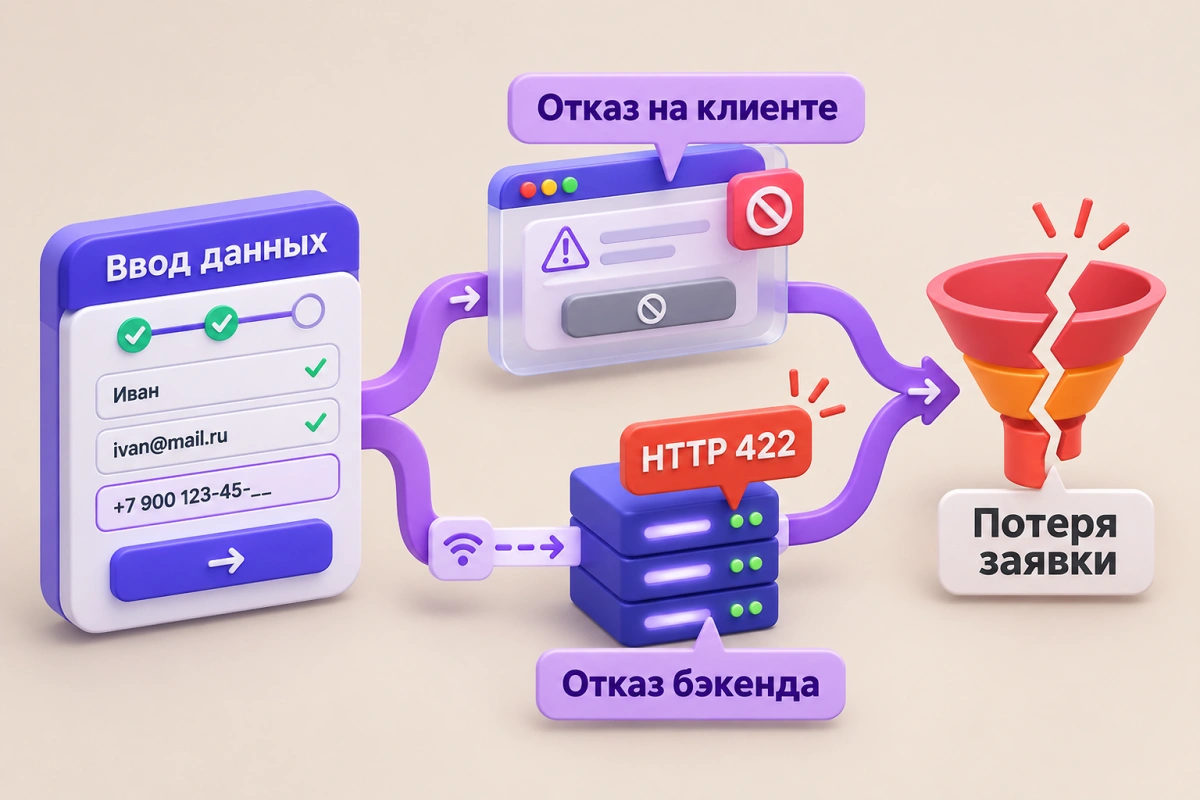
В браузере сетевой запрос проходит через цепочку ограничений безопасности, DNS-резолвинг провайдера и особенности локального соединения. Если запрос к API падает на этапе предполетного OPTIONS-запроса из-за неверной настройки Access-Control-Allow-Origin, серверный обработчик логики даже не запускается, а пользователь видит заблокированную кнопку.
Критичные сетевые проблемы обычно распределяются по нескольким сценариям:
- Сетевые таймауты и прерывания, когда приложение слишком долго ожидает ответ сервиса доставки или авторизации при нестабильной связи.
- Ошибки политик безопасности браузера, включая сбои CORS и блокировки Mixed Content при обновлении сертификатов.
- Отказы внешних API и виджетов третьих сторон, например сервисов факторинга, геокодинга или эквайринга, недоступность которых ломает сценарий покупки.
- Ошибки сериализации и несоответствия контрактов, когда сервис возвращает статус 200, но структура ответа изменилась и вызвала сбой парсинга JSON.
Перехват сетевых событий: Fetch, XHR и PerformanceObserver
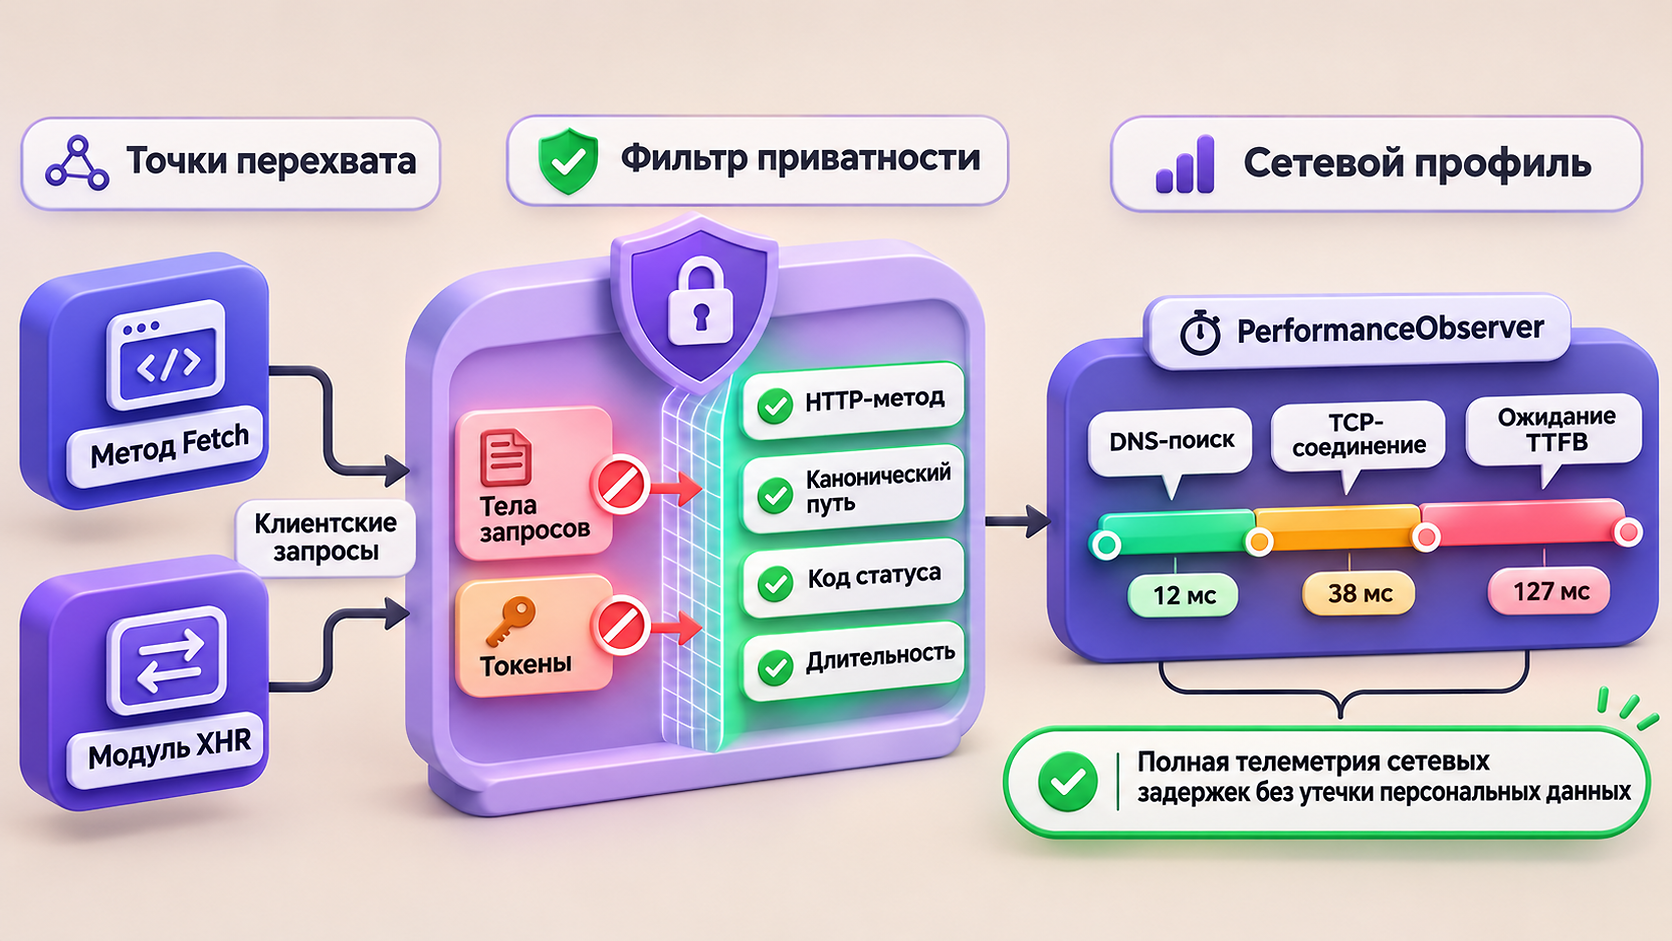
Сбор телеметрии в браузере строится на перехвате стандартных интерфейсов отправки запросов: window.fetch и XMLHttpRequest. Обёртка над нативным методом позволяет зафиксировать момент старта, URL эндпоинта, итоговый HTTP-статус, время выполнения и сам факт сетевого сбоя (TypeError при сбое сети у fetch).
При настройке перехватчиков важно строго соблюдать безопасность данных. Тела запросов и ответов никогда не должны передаваться целиком в открытом виде: они содержат токены авторизации, пароли и персональные данные клиентов. Достаточно логировать HTTP-метод, канонический путь эндпоинта без конфиденциальных параметров в строке запроса, статус ответа, длительность в миллисекундах и тип возникшей ошибки.
Дополнительно полезно использовать PerformanceObserver с типом ресурса resource. Этот API предоставляет точные метрики времени на уровне сетевого стека: длительность DNS-поиска, время установки TCP-соединения и ожидания первого байта (TTFB). Это позволяет разработчикам точно понять, вызвана ли задержка сетевой деградацией или медленной работой конкретного микросервиса.
Сигналы поведения: как распознать фрустрацию пользователя
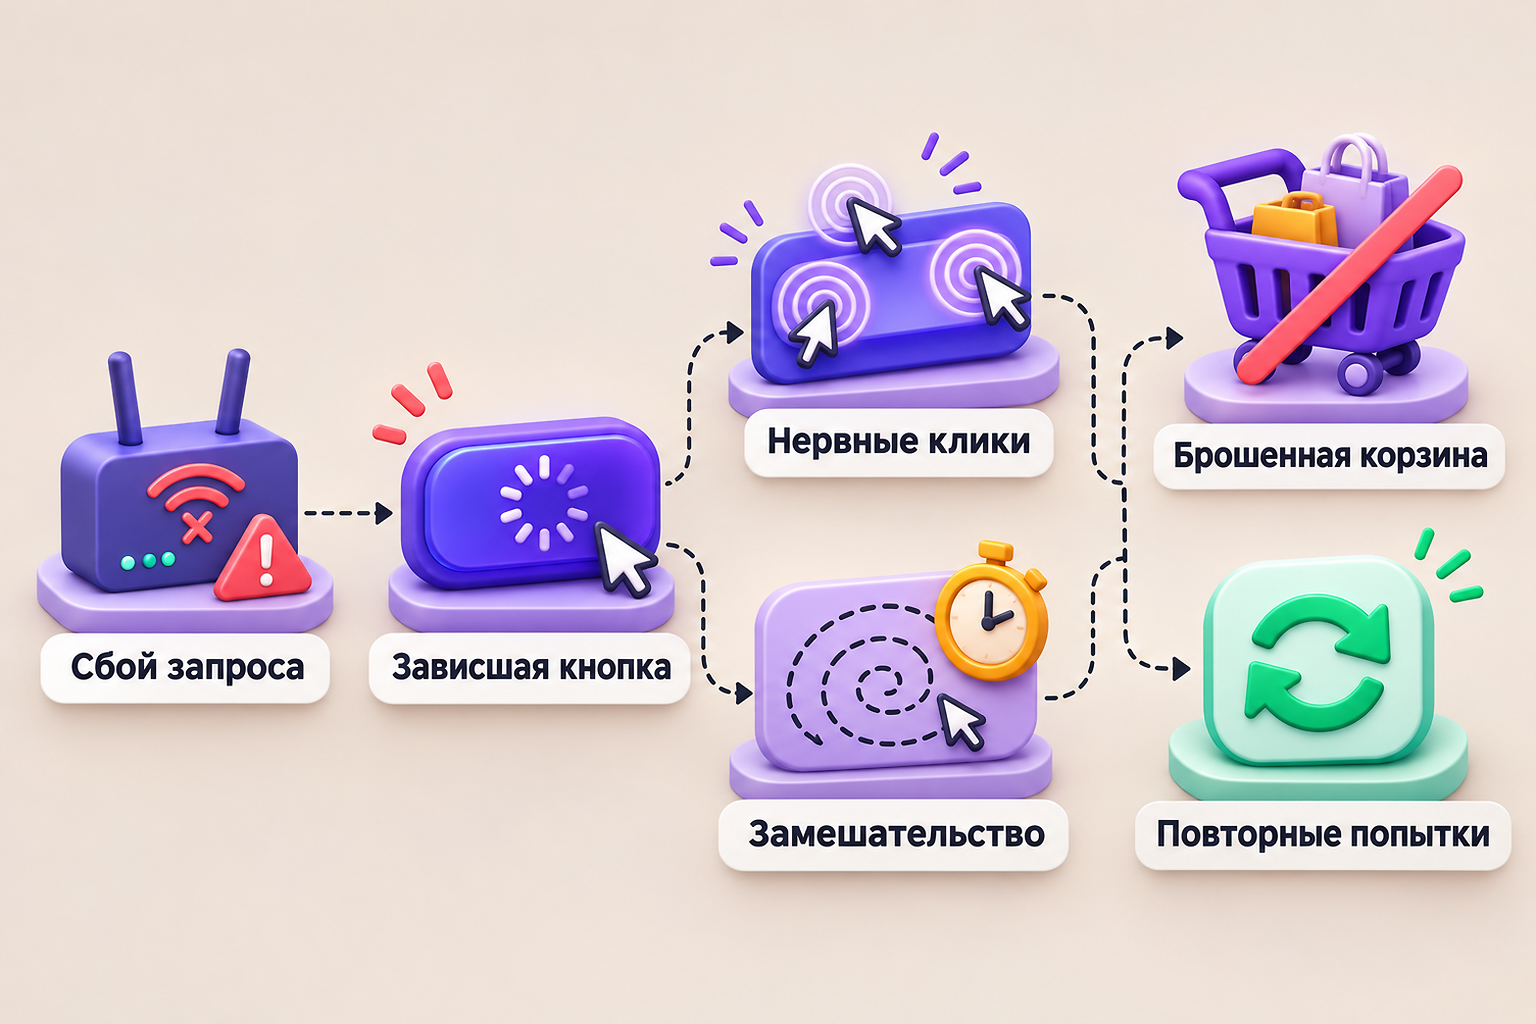
Сам по себе факт неудачного запроса не всегда означает катастрофу, если интерфейс корректно показал уведомление и предложил альтернативу. Настоящая потеря аудитории происходит тогда, когда сетевой сбой блокирует интерфейс, оставляя человека в неведении. В таких случаях технический сбой моментально трансформируется в поведенческие аномалии.
Маркетологи и продуктовые аналитики могут выявлять падение бэкенда по резкому всплеску нервных кликов (rage clicks), когда пользователь многократно нажимает на зависшую кнопку оформления. Другой характерный сигнал — длительное замешательство (hesitation), когда посетитель проводит на этапе оформления аномально много времени, двигает курсор по некликабельным элементам или пытается повторно перезагрузить страницу.
Связывая неудачный статус сетевого запроса с последующим поведением, команда получает четкий контекст: бросил ли клиент корзину сразу после ошибки или предпринял несколько попыток, столкнувшись с неработающей кнопкой.
Приоритизация ошибок: отделение фонового шума от потерь бизнеса
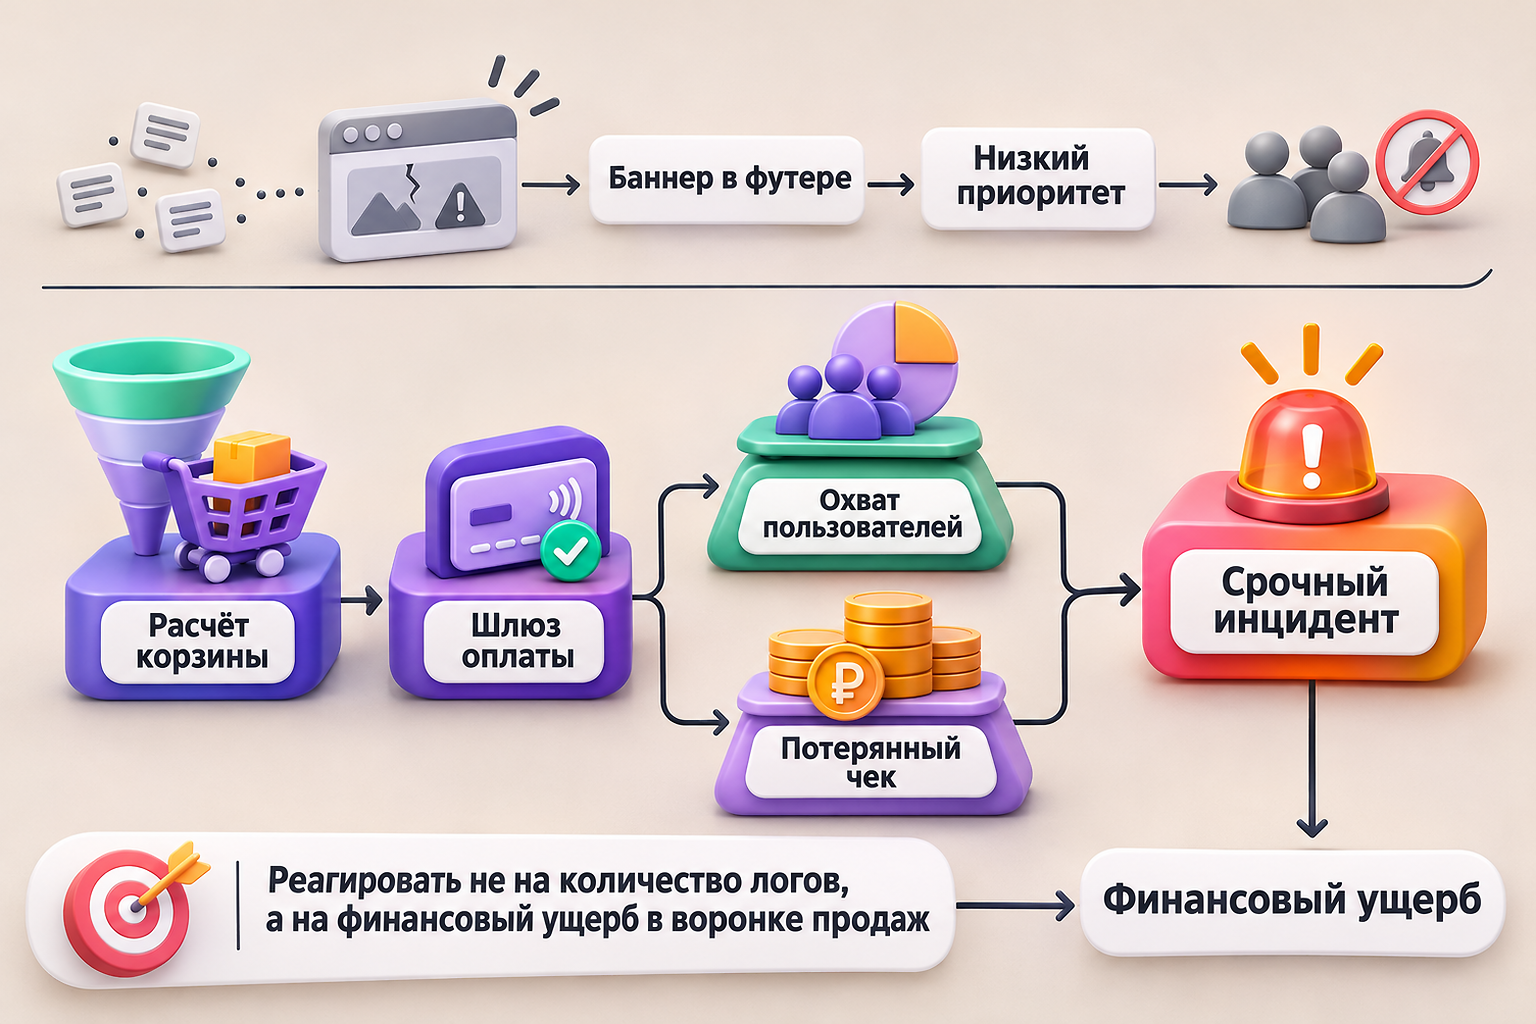
На нагруженном проекте ежедневно происходят тысячи сетевых микросбоев: случайные потери пакетов в метро, агрессивная блокировка трекеров плагинами или временные лаги мобильных операторов. Пытаться чинить каждый единичный сетевой таймаут неэффективно и ресурсозатратно.
Для управления инцидентами необходима матрица приоритизации, связывающая эндпоинты с коммерческой ценностью. Ошибка загрузки второстепенного баннера в футере имеет минимальный вес. Та же самая ошибка при вызове сервиса расчета корзины или подтверждения номера телефона блокирует основную конверсионную воронку и требует немедленного оповещения дежурной команды.
Чтобы приоритизировать задачи, инциденты оценивают не по абсолютному числу ошибок в логах, а по доле затронутых уникальных пользователей и суммарной стоимости незавершенных сессий в когорте пострадавших.
Как измерить эффект после исправлений и проверить результат
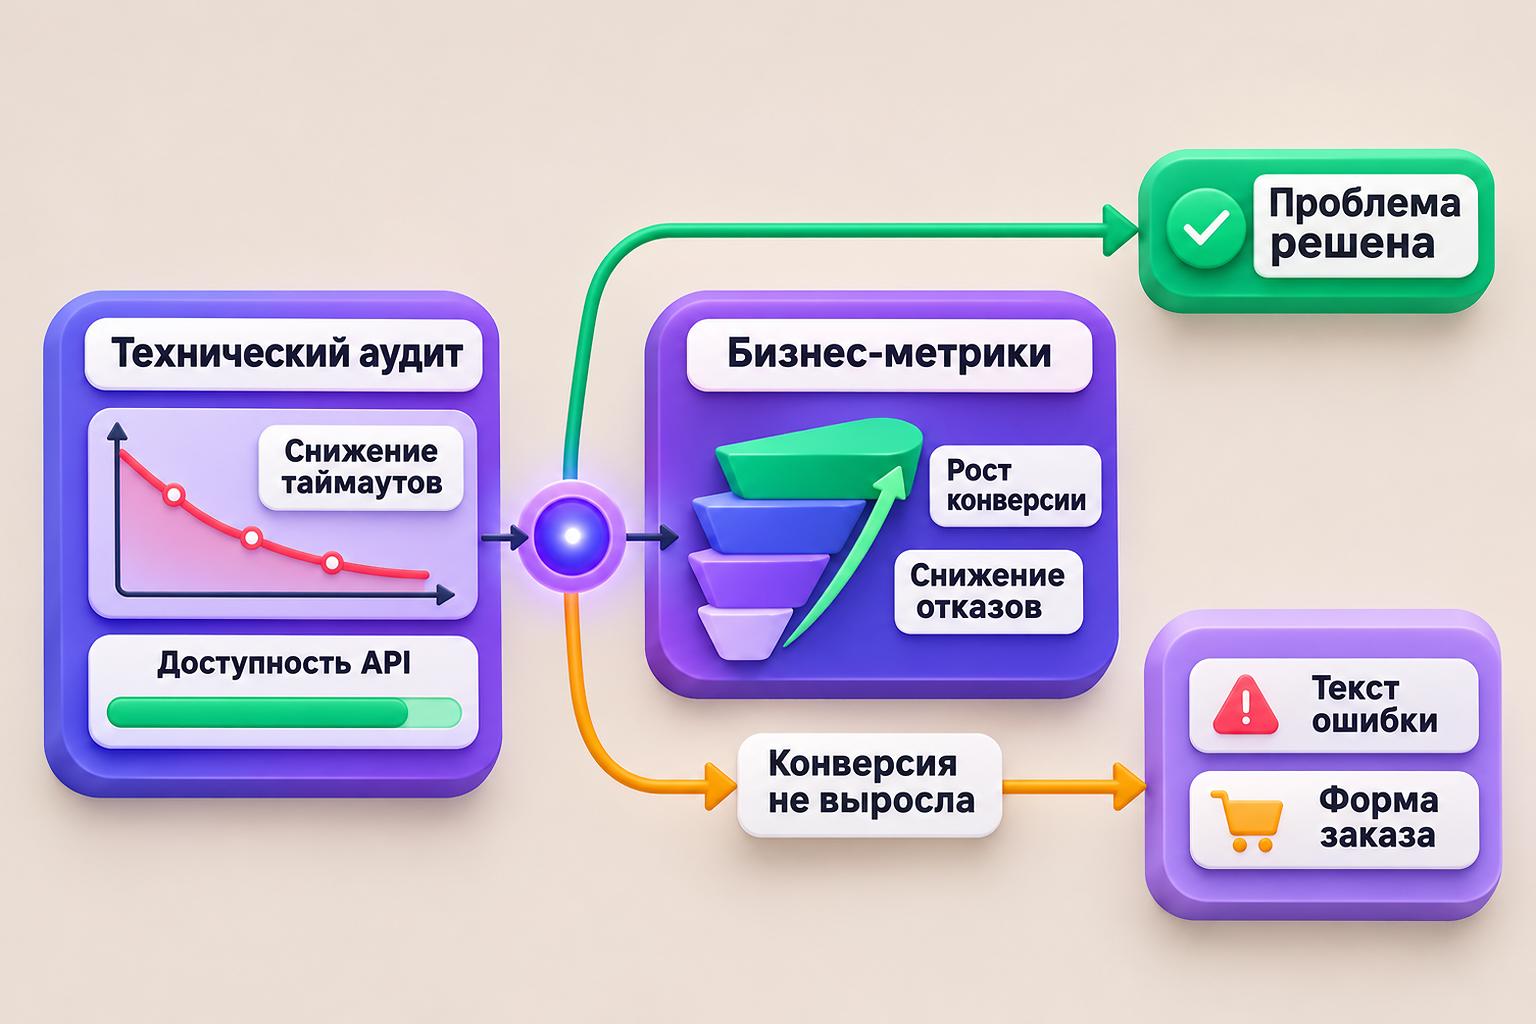
После оптимизации сетевой инфраструктуры, настройки повторных попыток запросов (retry) или исправления конфигурации CORS необходимо объективно проверить результат. Для этого сравнивают технические и поведенческие метрики за равные периоды до и после релиза.
Первым шагом оценивают динамику клиентской доступности API: процент успешных запросов к критическим эндпоинтам и долю сессий с сетевыми ошибками на ключевых шагах воронки. Если таймауты устранены, кривая ошибок должна резко пойти вниз, а показатели времени ожидания ответа стабилизироваться.
Вторым шагом маркетолог и владелец продукта замеряют конверсию перехода между этапами, где ранее происходил сбой. Исчезновение сетевых сбоев должно сопровождаться снижением процента отказов на шаге оплаты и сокращением числа нервных кликов. Если сетевые показатели улучшились, а конверсия не выросла, причину следует искать глубже — в неясных текстах ошибок, неудобных формах или изменившихся условиях покупки.