Когортный анализ оттока: как выявить технические релизы и интерфейсные изменения, снизившие удержание
Как вовремя заметить влияние неудачного релиза или редизайна на удержание аудитории? Разбираем, как связать когортный анализ оттока с техническими метриками, журналами ошибок и поведенческими сигналами пользователей.
Почему валовые метрики маскируют деградацию продукта
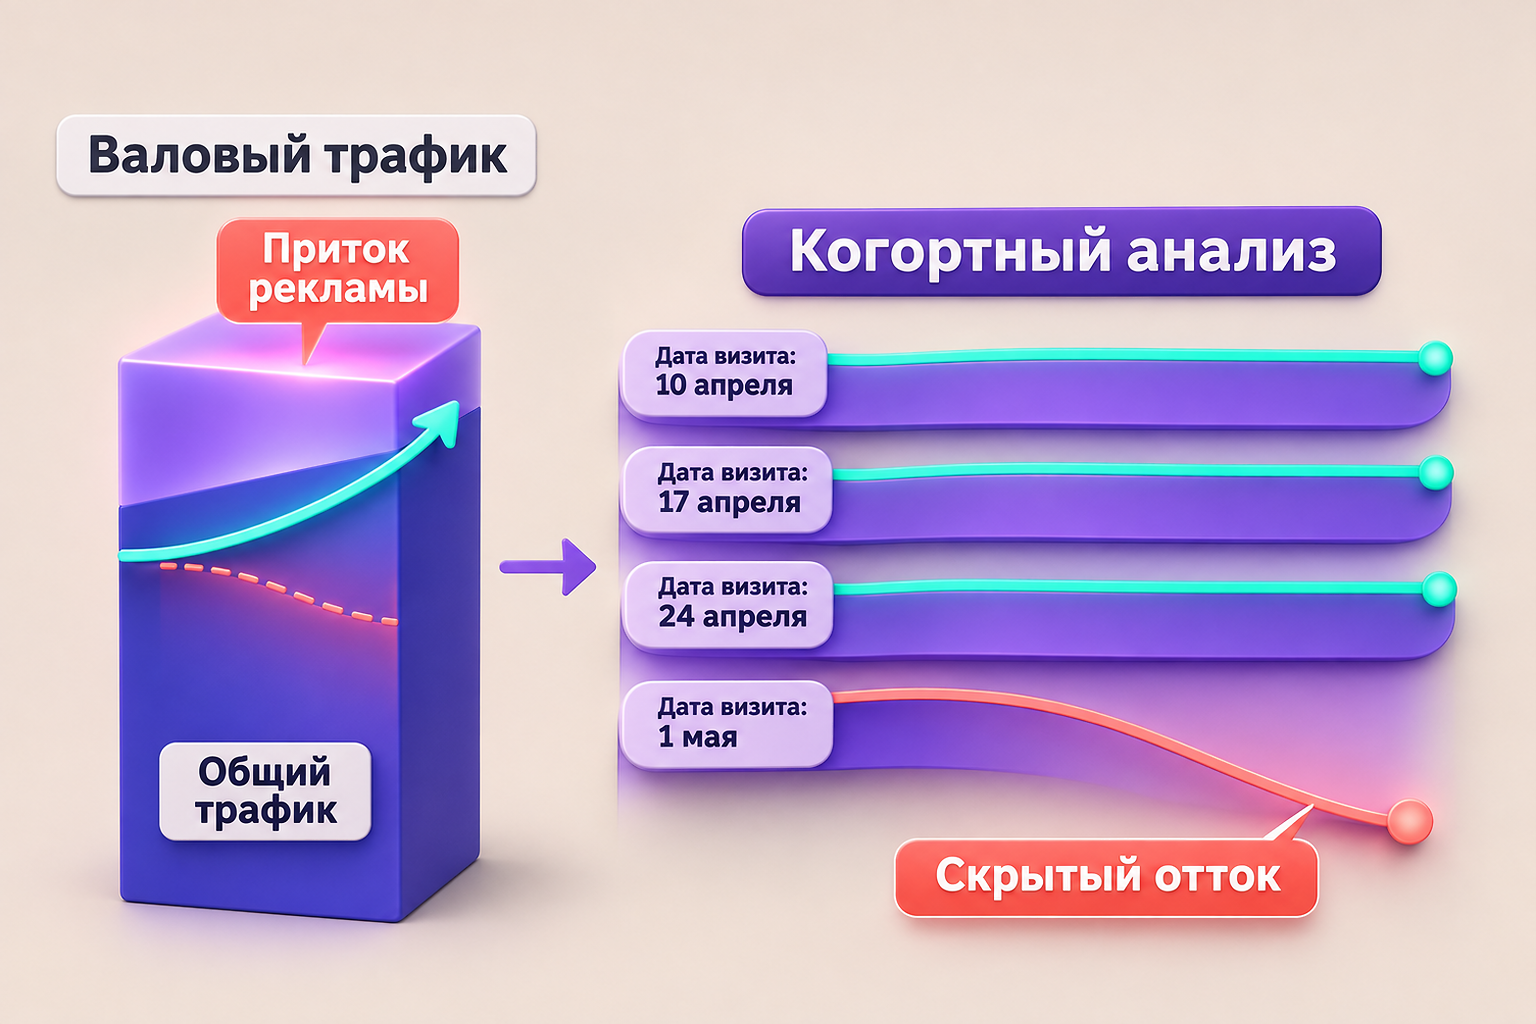
Общие графики посещаемости, дневная аудитория и совокупный объем заказов часто создают опасную иллюзию благополучия. Если маркетинговый отдел параллельно масштабирует платную рекламу, приток новых посетителей легко перекрывает тихий уход постоянных клиентов. В результате бизнес видит стабильный или даже растущий график, пока фундамент продукта постепенно разрушается.
Когортный анализ решает эту проблему за счет группировки людей по общему признаку — чаще всего по дате первого визита или совершения ключевого действия. Когда вы следите за поведением каждой группы изолированно, становится видно, какая доля клиентов возвращается на следующий день, через неделю или через месяц. Если кривая удержания в свежих когортах начинает опускаться круче, чем в предыдущих, проблема кроется внутри самого сервиса, а не во внешних факторах привлечения.
Синхронизация когорт с графиком релизов и изменений UI
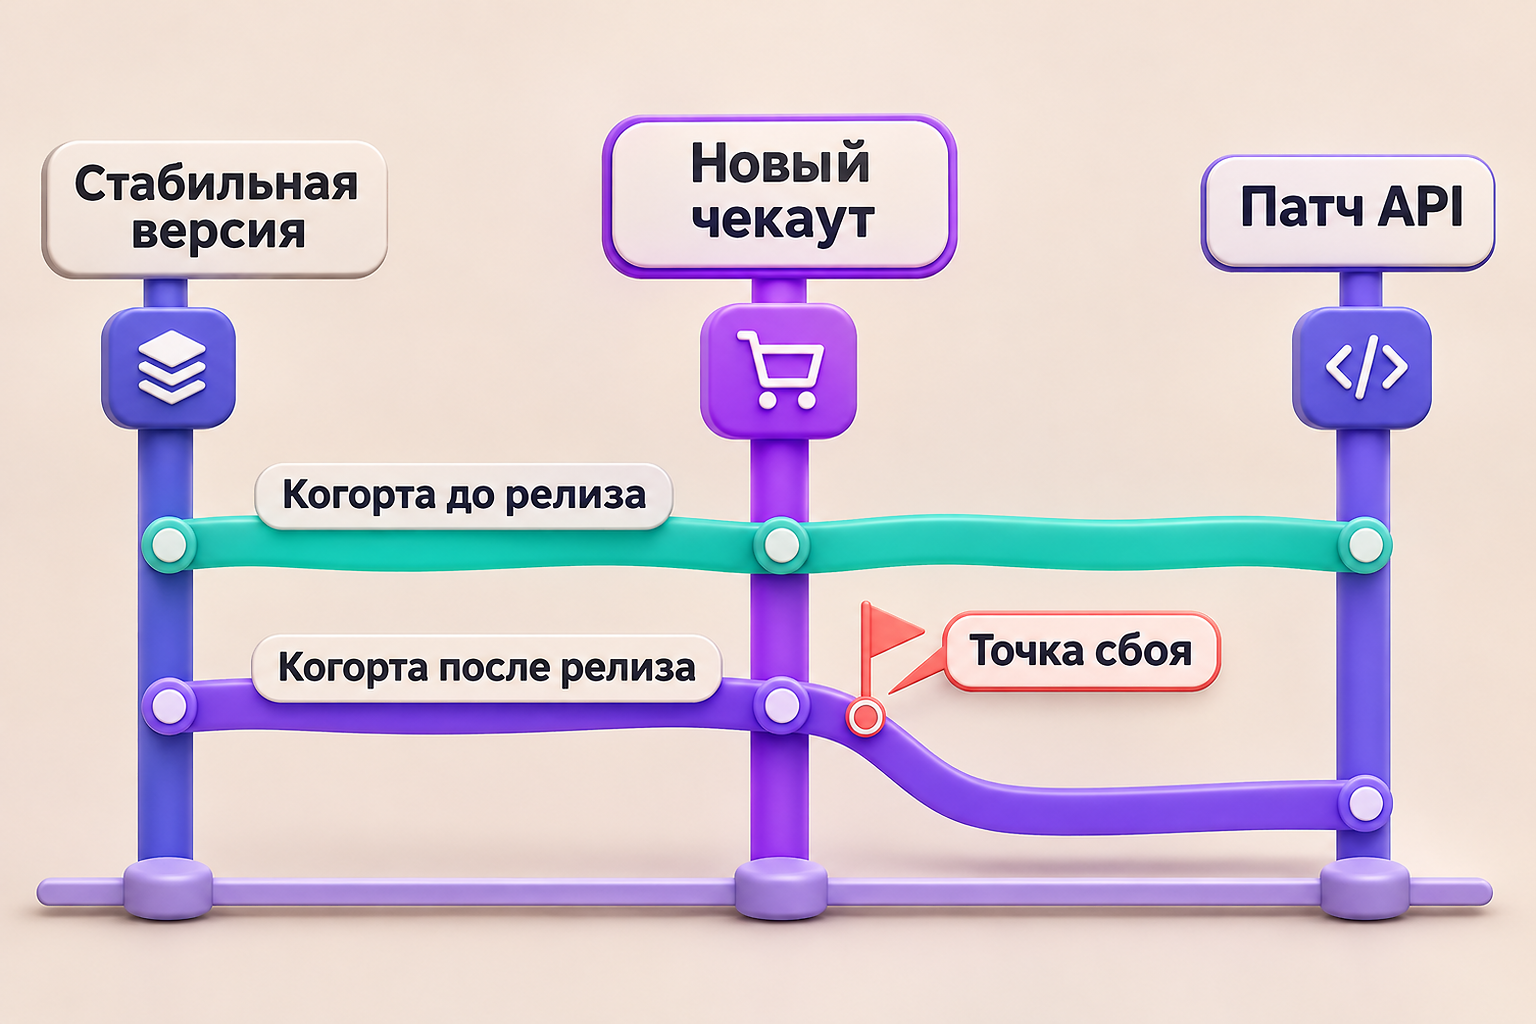
Традиционное деление на календарные недели и месяцы удобно для финансовой отчетности, но плохо подходит для поиска инженерных и продуктовых сбоев. Чтобы понять, какое именно изменение спровоцировало отток, когорты необходимо привязывать непосредственно к моментам выкатки обновлений. Границами групп должны становиться даты релиза нового чекаута, миграции на другой интерфейсный фреймворк или изменения шагов регистрации.
Для объективной оценки важно сравнивать пользователей со схожим опытом. Разделите аудиторию на тех, кто взаимодействовал только со старой версией интерфейса, и тех, кто пришел сразу после обновления. Если кривая удержания Rolling Retention или Classic Retention у новой когорты резко проседает на конкретном этапе пути, вы сразу получаете точную точку отсчета для локализации дефекта.
Поведенческие сигналы и технические симптомы перед уходом
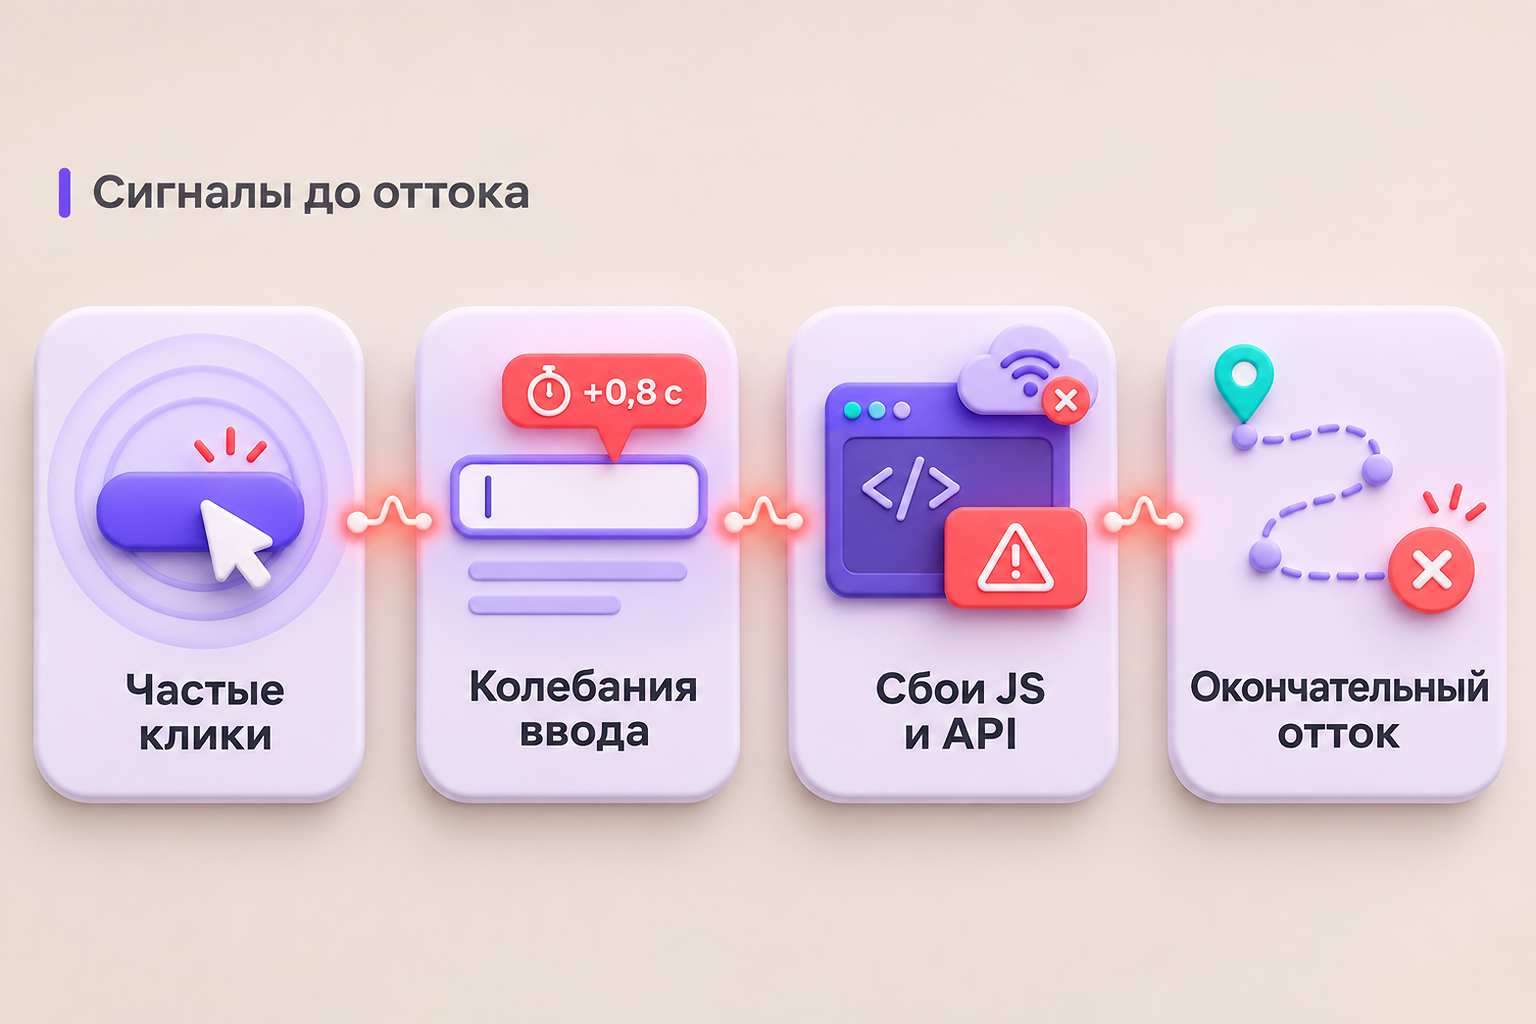
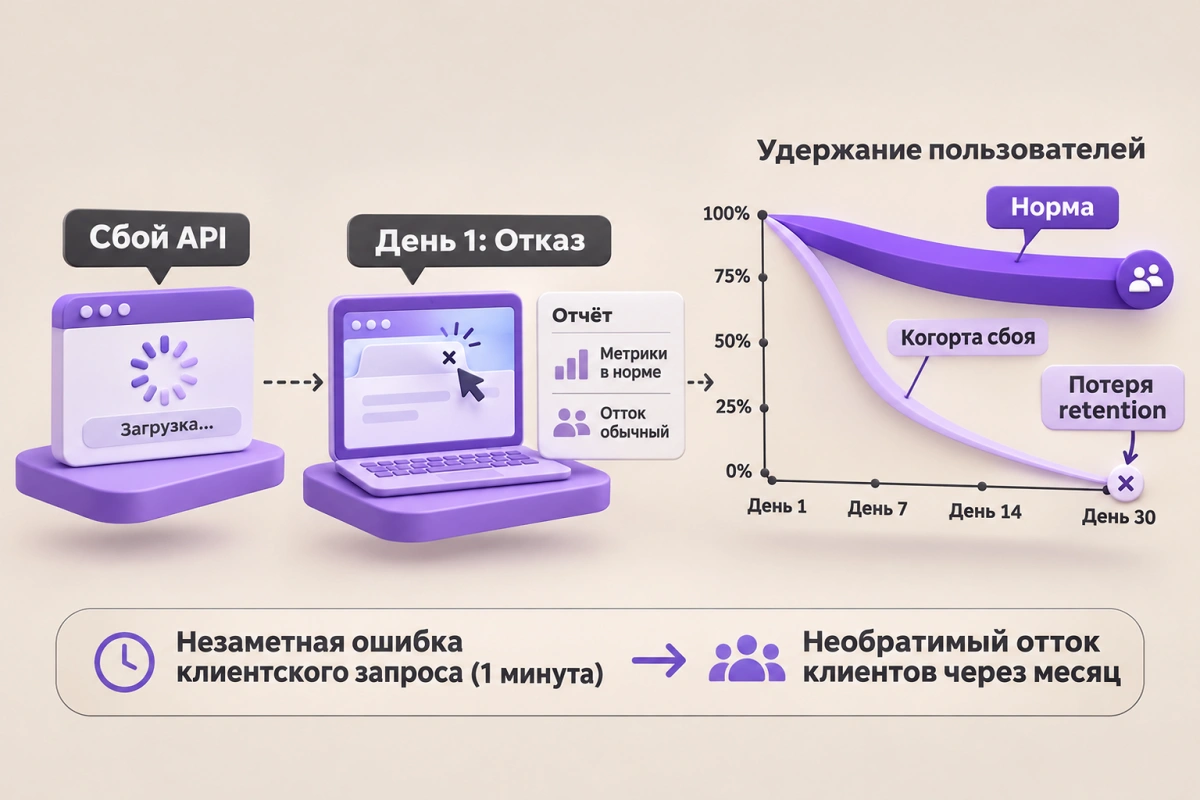
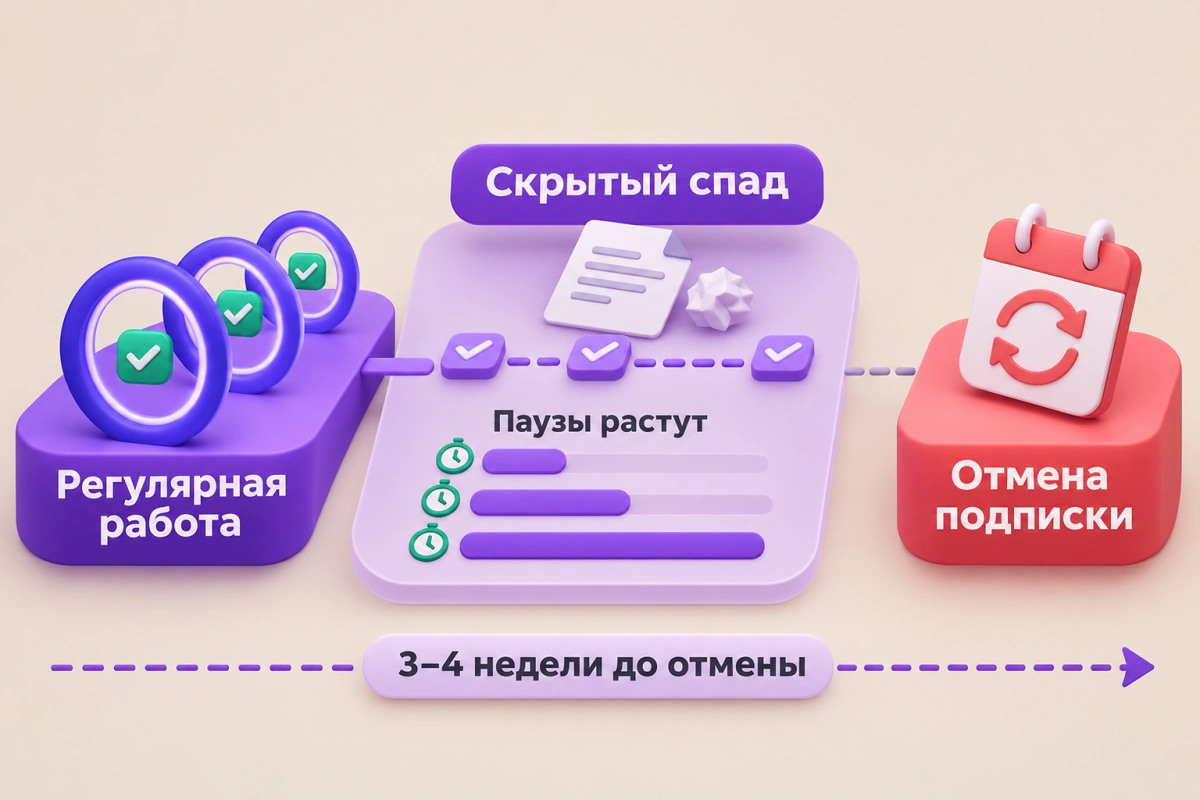
Пользователи редко принимают решение об окончательном уходе спонтанно. Потере интереса практически всегда предшествует цепочка негативного опыта: медленный ответ сервера, неожиданная перезагрузка формы или неочевидное поведение обновленных кнопок. Анализ таких микрособытий позволяет понять физическую причину оттока еще до того, как когорта полностью угаснет.
Отслеживание таких сигналов позволяет выявить барьеры еще до появления прямых жалоб в техническую поддержку. Это переводит диагностику оттока из плоскости интуитивных догадок в область объективных технических и поведенческих метрик.
Вместо субъективных догадок стоит отслеживать измеримые маркеры трения в интерфейсе, которые коррелируют с прекращением сессий:
- Серии частых кликов по одному элементу (rage clicks), указывающие на зависание скрипта, некликабельный элемент или отсутствие визуального отклика.
- Колебания курсора и нетипичные паузы перед полями ввода (hesitation), сигнализирующие о непонятной валидации или сбивающей с толку подсказке.
- Ошибки выполнения JavaScript и сетевые сбои API (статусы 4xx и 5xx), блокирующие отправку форм и переход между экранами без видимого для пользователя уведомления.
Диагностика первопричины: разделение сбоев кода и ошибок UX
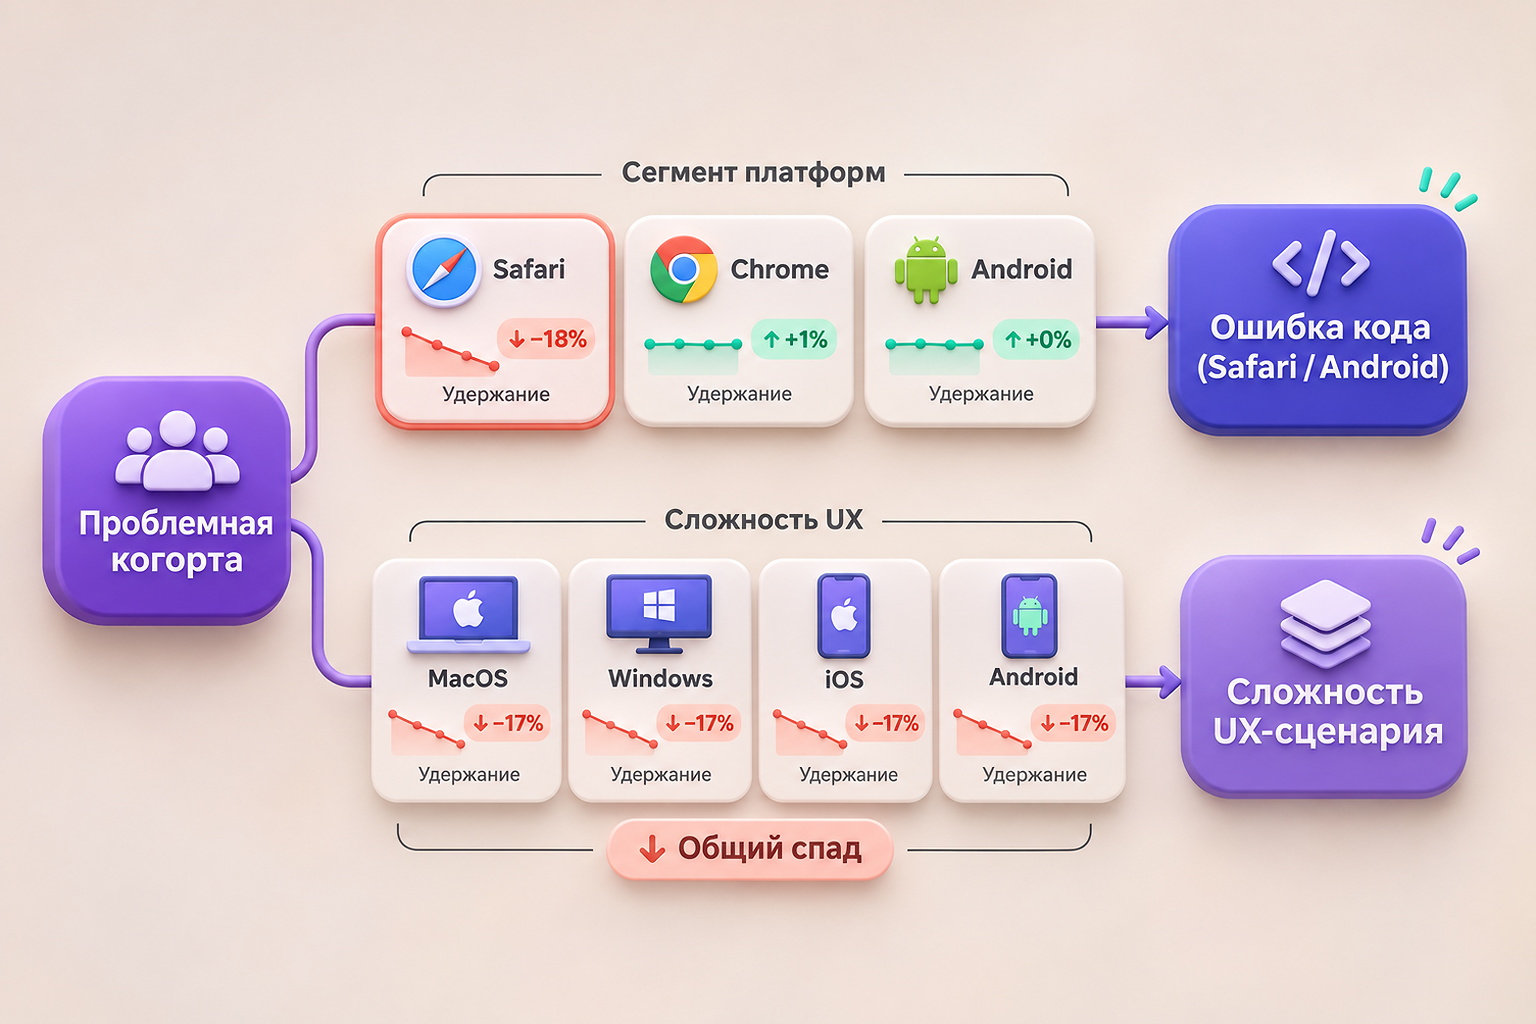
Когда когорта демонстрирует ускоренный отток, команде важно быстро разделить ответственность между продуктовой логикой и технической стабильностью. Падение конверсии и возвратов может быть вызвано как неудобным расположением элементов, так и банальной поломкой скрипта под определенной операционной системой. Чтобы не тратить время на бессмысленные споры, начните диагностику с технической сегментации.
Проверьте удержание в проблемной когорте в разрезе платформ, браузеров и типов устройств. Если отток концентрируется, например, только в мобильном Safari или на старых версиях Android, причина почти наверняка носит инженерный характер: некорректная полифилизация, конфликт стилей или блокировка сторонних скриптов. Если же удержание равномерно деградировало по всем сегментам аудитории, проблему стоит искать в усложнившейся логике нового сценария, неудачном ценообразовании или скрытых дополнительных шагах воронки.
Как измерить результат исправлений и подтвердить восстановление
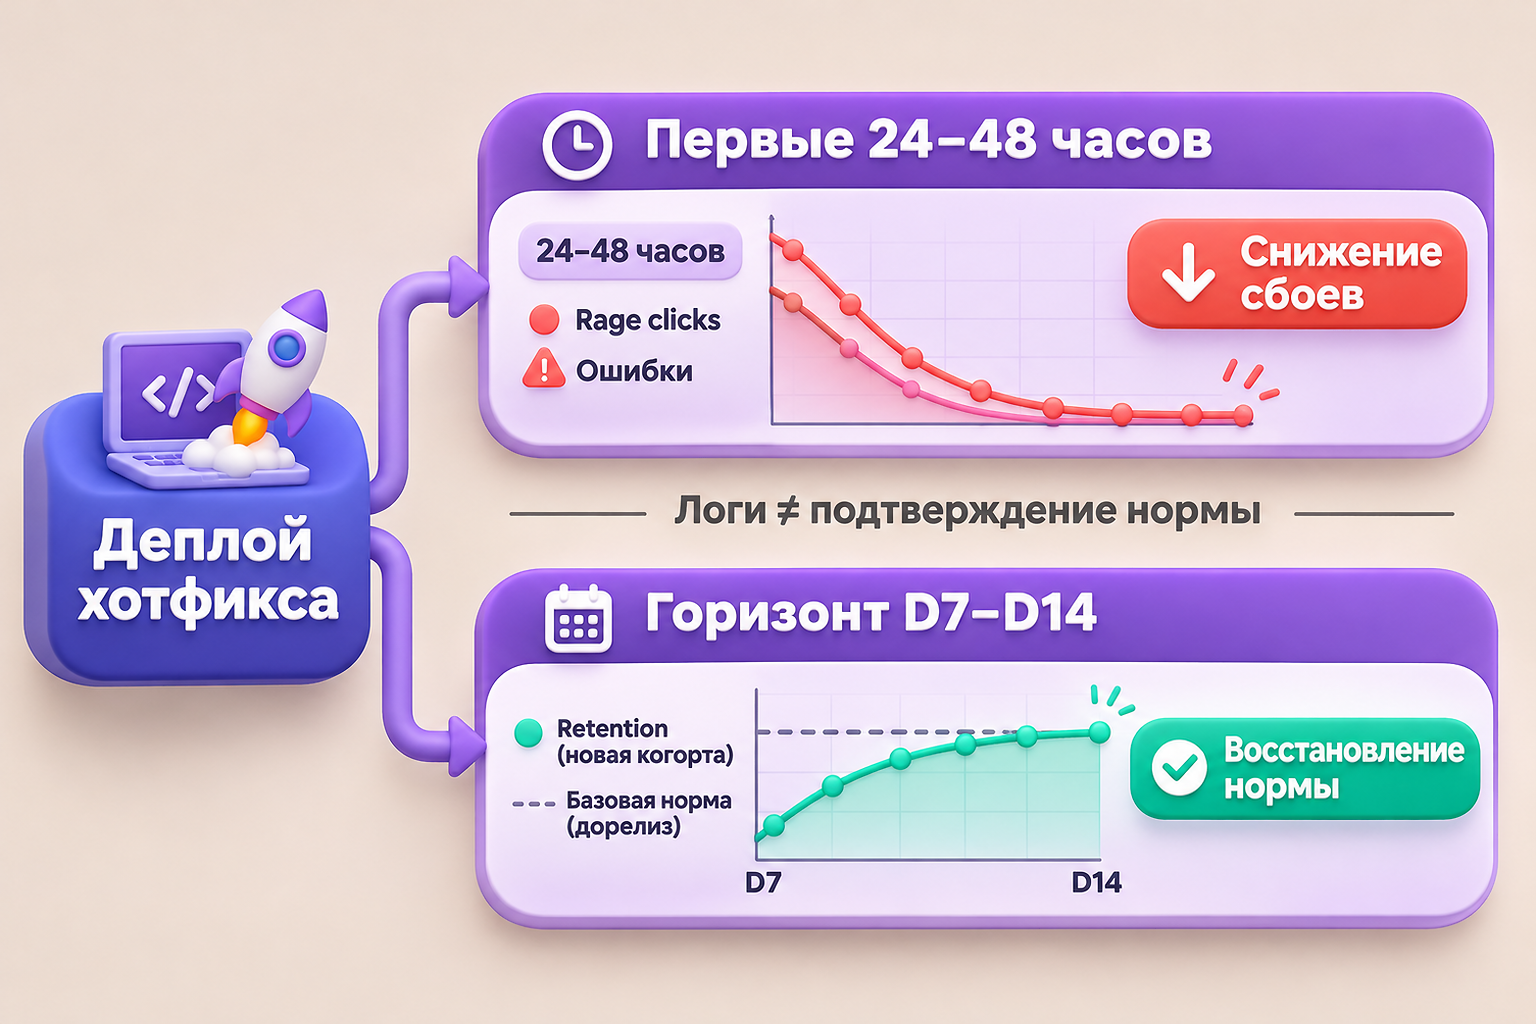
После выпуска исправлений нельзя ориентироваться только на факт исчезновения сообщений об ошибках в логах. Технический хотфикс считается успешным только тогда, когда он восстанавливает продуктовые показатели удержания в последующих когортах. Для надежной проверки сформируйте контрольную когорту пользователей, начавших работу сразу после деплоя патча.
Оценивайте эффект по двухуровневой системе метрик. На оперативном уровне в первые 24–48 часов отслеживайте снижение доли сессий с техническими сбоями, частоту возникновения rage clicks и прохождение воронки до первого целевого действия. На горизонте одной–двух недель сравните показатели удержания D7 и D14 новой когорты с дорелизным базовым уровнем. Только совпадение этих графиков или их превышение подтверждает, что первопричина оттока полностью устранена.
Построение непрерывного контроля релизов без рутинного аудита
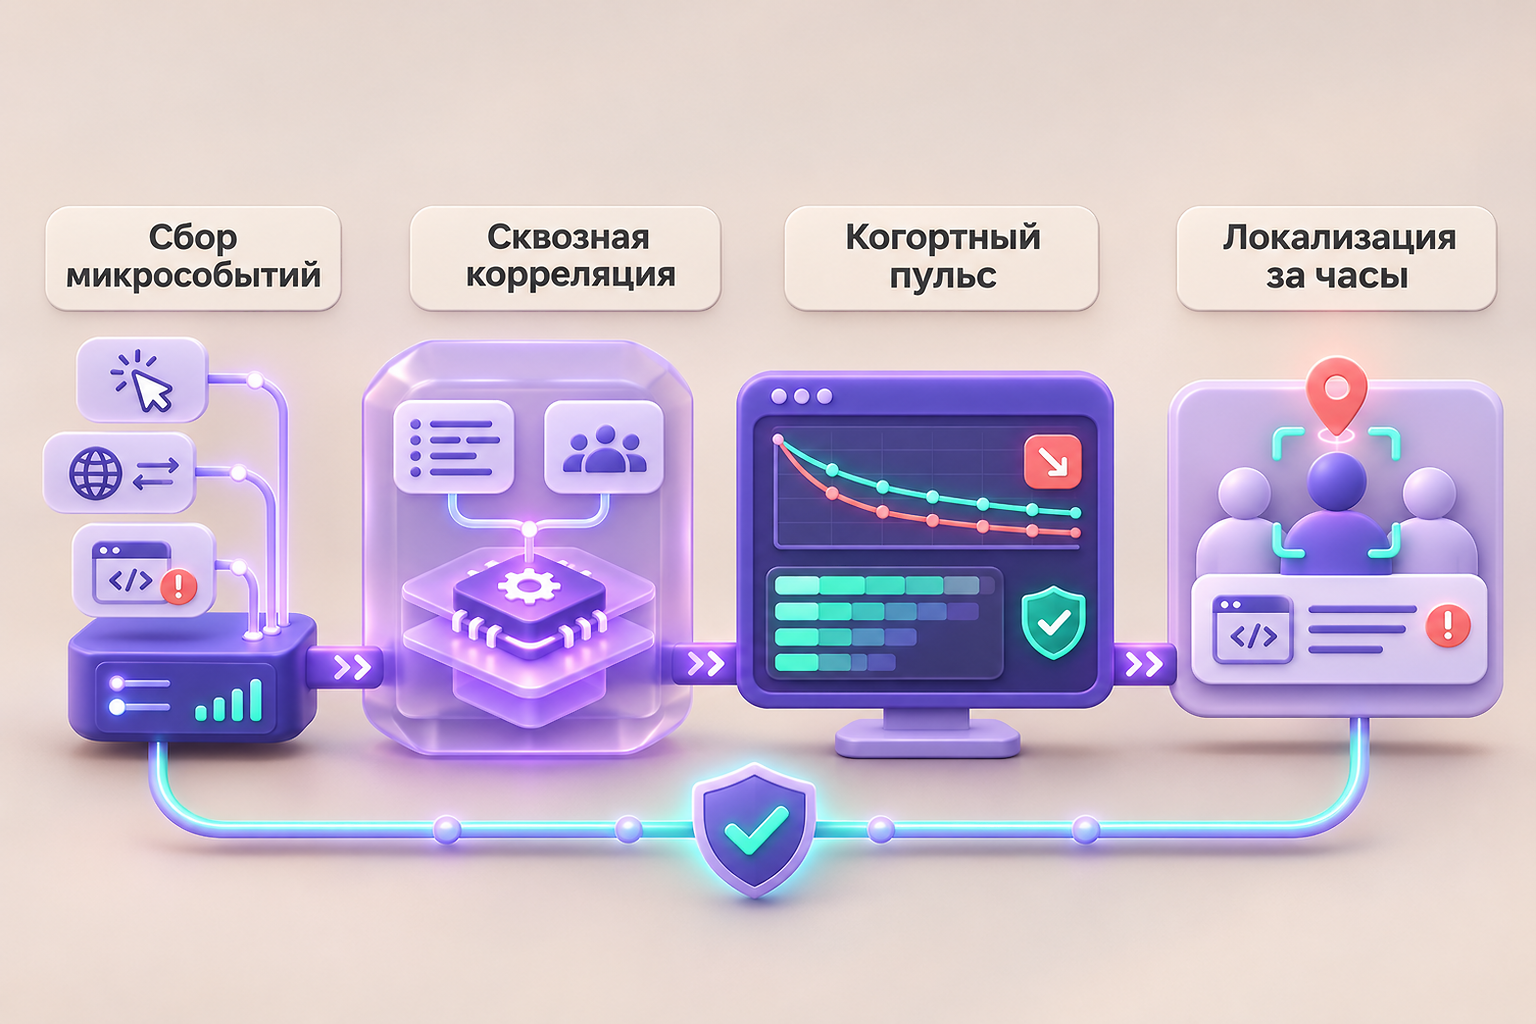
Ручной разбор пользовательских сессий после каждого релиза отнимает десятки часов и не дает статистической репрезентативности. Современный подход заключается в сквозном связывании технических событий с бизнес-показателями когорт. Команда должна получать сигнал о деградации интерфейса не из гневных обращений в поддержку, а из аномалий в поведении трафика.
Автоматическая фиксация событий интерфейса, ошибок в консоли браузера и сбоев сетевых запросов позволяет мгновенно сопоставить каждую жалобу с контекстом сессии. Когда разработчики и продакт-менеджеры смотрят на единую картину происходящего, исправление критических багов занимает часы, а когорты постоянных пользователей остаются защищенными от неожиданных просадок.